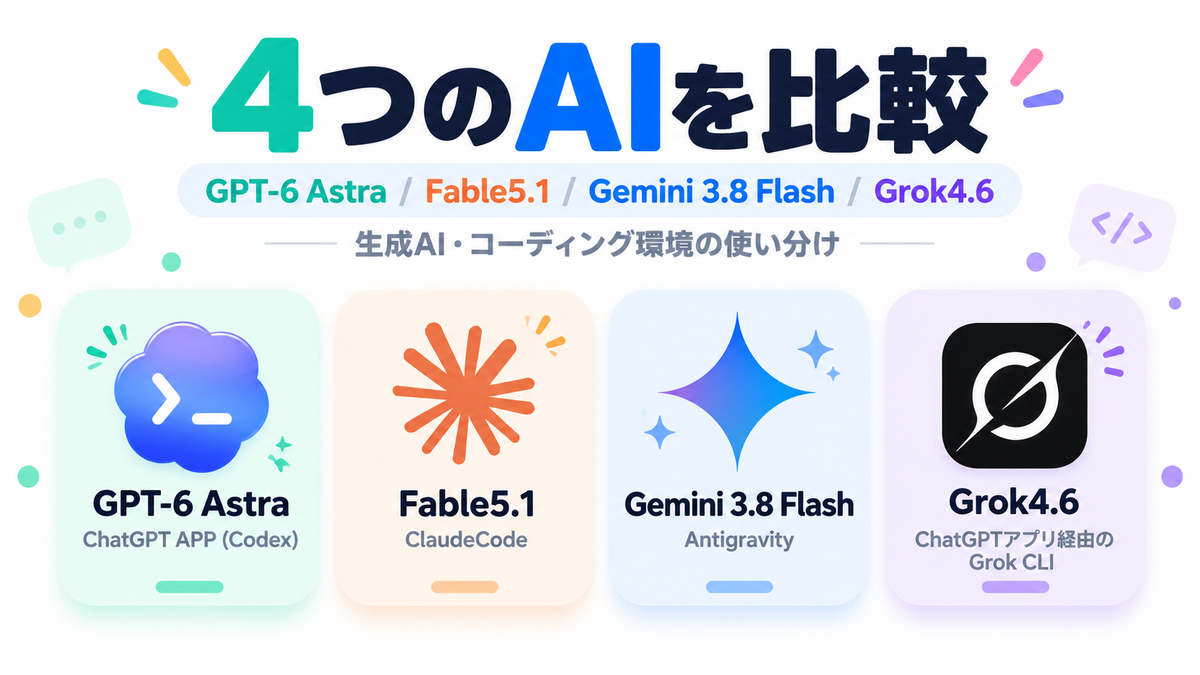
 9月はAIラボ各社のフロンティアモデル投入ラッシュでした。中でも話題をさらっていったのが「GPT-6 Astra」です。Astraの詳細はまだいろいろ試し中なので、今日は各フロンティアモデルの「日本語能力」について、比較してみようと思います。
4つのAIが書いたエッセイ
今回4つのフロンティアモデルに日本語のエッセイを書いてもらいました。純粋に日本語能力を比較するため、リサーチと構成の作成はFable5.1が行い、その資料に基づいて執筆をしてもらいました。情報はmdファイルとして用意し、基本的に各社純正ハーネスから動かしています。
- GPT-6 Astra(ChatGPT APP(Codex))
- Fable5.1(ClaudeCode)
- Gemini 3.8 Flash(Antigravity)
- Grok4.6(ChatGPTアプリ経由のGrok CLI))
テーマは「AIの進歩 → RSI(再帰的自己改善)→ AGI → ASI に至る流れと、そのリスク」。500字エッセイで、書き手は「気鋭のエッセイスト」。解説ではなく、ひとつの鋭い見立てを置いて切るという依頼です。
4つのモデルが書いたのは下記のA〜Dの文章です。さて、どれが一番AI臭いでしょう。そしてどれが人間っぽいでしょう?
A:宣言できる節目は、もう節目ではない
九月三日、OpenAIは新モデルの発表会で「AGI時代へようこそ」と宣言した。独立系の性能指標は前世代から動いていない。宣言と計測が、同じ日に別の方向を向いた。
不思議はない。幹部自身が、AGIは契約上のトリガーではなく「精神上の概念」になったと言い換えている。定義が緩んだから宣言できるのであって、何かを越えたから宣言したのではない。宣言できる節目とは、宣言に値しなくなった節目である。
本当に不可逆な段階は、記者会見には出てこない。AIがAIを作る速度が人間の手を離れる段階の証拠は、業務報告として出る。OpenAIは今年二月、新モデルが自分自身の訓練のデバッグと評価分析を手伝ったと述べた。Anthropicは社内コードの大半をAIが書くという。どれだけ速くなったのか。METRの対照実験では一・二倍、Anthropicの社内調査では四倍である。一・二倍なら人間のペース、四倍なら数年で研究者は要らなくなる。同じ現象を測って桁が違う。速度が一桁の幅で分からないものを、われわれは制御対象と呼んでいる。
AGIは記者会見で来る。ASIは、来たと誰も言えない形で来る。見るべきは発表会ではなく、各社がAIに書かせたコードの比率である。
B:宣言されない超知能
OpenAIが「AGI時代へようこそ」と高らかに宣言したとき、起きたのは知能の質的跳躍ではなく言葉の変質であった。かつて人類最後の発明と恐れられた閾値は契約上のトリガーから精神的概念へと看板を塗り替えられた。世界に向けて大々的に告知できる節目とは、定義が緩み祝祭へと変わった証拠にほかならない。
一方、本当に不可逆な再帰的自己改善は会見の壇上ではなく開発現場の業務報告に潜んでいる。モデルが自らの構築や訓練のデバッグを手伝い、Anthropicでは社内コードの大半をAIが書く。自律的な改善ループは告知されるイベントではなく日常の侵食としてすでに始まっている。
その進行速度について人類は合意した尺度すら持たない。AIが研究を加速させる倍率の推計は対照実験の1.2倍から当事者調査の4倍まで大きく割れている。制御すべき対象の速度すら桁の幅で掴めていない現状こそが最大の盲点である。
AGIは華やかな発表会とともに訪れるが、超知能は誰も宣言できない静けさの中で閾値を越える。注視すべきは壇上の演説ではなく、コードの書き手が人間から機械へと静かに移り変わっていく日々の推移である。
C:承認ボタンを押す人間
OpenAIはGPT-5.3-Codexの初期版が自らの開発を手伝い、評価結果の分析にも使われたと公表している。自分を際限なく賢くする能力が証明されたわけではない。だが、作る仕事と出来を確かめる仕事の両方に、同じ技術が入り始めた。
AIが改良を重ねる再帰的自己改善には、確認作業も速くしたいという誘惑が伴うだろう。改良案が次々に届けば、人間による検証は待ち時間になる。その解消までAIに任せたらどうか。開発者は最後の承認ボタンを押せる。しかし、なぜ押してよいのかを自分で確かめる機会は減っていく。
国際AI安全報告書は、技術の変化にリスクや対策の証拠が追いつかないと指摘する。確認を急ぐ理由はある。だからこそ、安全を確かめるための自動化が、安全だというAIの判断への依存を深める可能性もある。手元に評価書がそろっていても、その正しさまで保証されたことにはならない。
汎用人工知能(AGI)か超知能(ASI)かを論じる間にも、承認する人間の仕事は変わりうる。署名だけが残れば、書類の上では人間が管理していることになる。危うい境目は、承認ボタンを押す人間が、その判断の理由をAIにしか尋ねられなくなる時である。
D:宣言される到達
OpenAIは新型の発表で「Welcome to the AGI era」と宣言した。独立指標では点数は前世代と同じ61である。物差しが静止したまま、言葉だけが先に着いた。契約上のトリガーではなくミッション上・精神上の概念になったと説明された時点で、AGIは閾値ではなく、宣言可能なラベルになった。定義が緩むと、到達は証明されずに告知できる。
再帰的自己改善は、その宣言の外側で進む。モデルは自らの訓練のデバッグや配備、評価分析を手伝う。社内コードの大半を書く運用も、すでに報告されている。研究を速める倍率は、対照実験と社内調査で桁が違う。完了できる作業の長さは、測定器が上限に達するまで伸び続けた。国際報告書は、状況は速く変わるがリスクと対策の証拠はゆっくりしか出てこない、と書いた。超知能の開発を止めよという声明は出た。日本の基本計画には、AGIも超知能の語がない。測れない加速を、測れる到達の物語で上書きしている。
ASIは宣言されない。進行は業務報告にしか現れず、速度すら一桁の幅で測れていないからだ。危険は、宣言の有無ではなく、測定の欠落にある。われわれが節目と見ているものは節目ではない。
気になった点
では僕がみて気になった点を挙げていきます。まずAの「前世代から動いていない」は典型的な英語翻訳調でAIがよく書いてくる表現です。「別の方向を向いた」もそうですね。無生物が主語となって動きを表現するのは頻出のAI表現です。
冒頭の「不思議はない。」も、AIがよく使う手法です。最初に言い切ったり、結論を言って、そのあと説明するやり方です。これは人間でも使うしそこまで変ではないですが、AIっぽいな〜と思う出だしではあります。
「本当に不可逆な段階は、記者会見には出てこない。」。この部分では、句点に注目したい。これ、AIが作ったプレゼン資料とかでよくある構文で、短めに区切って句点を打つクセがあります。
続いてB。「閾値」という単語が気になります。英語の訳語としてもってきたか、気鋭のエッセイストが使いそうな単語だと思ったか。これ、AGIは世界が転換する閾値としていわれてきたが、それはもっと軽い表現に変わってしまった――という意味で、AGIを意味して閾値という表現を使っているわけですが、少し固い、というか気取りすぎ? でもまぁ文章としては固いものの、不自然な日本語表現はそれほどないかな。
そしてC。「仕事の両方に、同じ技術が入り始めた」ここがなんかAIくさい。人間が書くなら、「仕事の両方で、同じ技術が使われ始めた」と書くんじゃないかな。無生物主語の翻訳調がちょっとでている。
「確認を急ぐ理由はある。だからこそ、」あたりもいい流れ。短文でリズムを作り、そのあと長文を持ってくる。こういう文章の並びは、ポン出しのAIには案外苦手だった。
最後にD。「言葉だけが先に着いた」ここも典型的な翻訳調。「定義が緩むと、到達は証明されずに告知できる」なんとなく小難しい表現を使っている文章。英語を直訳した感じがでていますね。日本語ならもっとこなれた書き方ができるはずです。
後段は文章の箇条書き感がすごい。その理由の一つは全部語尾が同じことにあるでしょう。「書いた」「出た」「ない」「している」。単調なんです。
それぞれを書いたのはどのモデルか
どの文章がAIっぽいでしょうか。また、どれが一番うまく書けていると思いますか? 僕が自然な日本語としての評価を付けるなら、上位から順に、B>C>A>Dという順です。ただBは語彙が固すぎる嫌いがあります。
日本語の自然さとは別に気になった点もあります。同じ資料に基づいているのに、Cだけが異なる主題「AI開発における人間の役割」にフォーカスを当てています。資料では複数の構成案を提示していて、A案は「宣言できる節目と、できない節目」。3つのAIがこの推奨案にそってエッセイを書きました。B案は「速度計のない車」、C案は「日本は流れの外にいる」。ところが、Cはそのそれでもない主題で書いています。ちょっと困ったモデルですね。
さて、種明かしをすると、A〜Dは下記のモデルです。3.8Flashは意外と日本語がいい!という評判でしたが、僕のテストでもそれが裏付けられました。またAstraは一人だけ違うことを書いてしまいましたが、意外と日本語はいいです。最も素直な感じ。
薄々感じていたものの、日本語が劣化したとさえ感じたのがFable5です。鋭さアタマの良さは最高クラス(Astraとはまだ丁寧に比較できていないけど、Flashよりは確実に上)なのですが、Claude 3.5時代の頃に感じていた圧倒的な日本語性能は、今や失われた感じがします。コーディングにフォーカスした結果、言語能力は劣化した?という感じでしょうか。
- A Fable5.1
- B Gemini3.8 Flash
- C GPT-6 Astra
- D Grok4.6
もともと日本語性能については初期から「Claudeはいいよ!」と言われてきたし、ぼくもそれを実感していました。でも、今の素のClaudeはダメですね。Astraがかなり素直な日本語を出してくるし、Gemini3.8 Flashはダークホースでした。Grok4.6も案外いいです。
とはいえ、今回は事前リサーチと構成案を考えたがFableだということは留意が必要です。Geminiにはこういうプロットはまだ無理。でもAstraはいけるかもしれません。
そんなわけで、日本語を書くときは、CodexからAntigravity CLIを呼び出してGemini3.8 Flashに書かせることも検討しています。まともな日本語を書く性能はけっこう重要なことだと思うのです。
※この文章は言うまでもなく人間が書きました。
